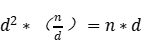基于广义后缀自动机拓展的泛基因图匹配算法
c++17、boost
可以使用sudo apt install libboost-all-dev
或者使用conda但是作者研究了半天还是没有研究出来怎么include虚拟环境下的boost。
快速入门: gsam -g test/chr4_GL000008v2_random.gfa -f test/wrong_read1000.fa -a res.gaf
帮助可以使用gsam --help、gsam -h、gsam -h参看参数
会得到如下结果
read1 999 0 998 + >s85234 1000 349 1349 989 1002 60 NM:i:13 AS:f:960.765 dv:f:0.0129741 id:f:0.987026 cg:Z:22=1D56M1I68=1X26=1X11=1X33=1X104=1X96=1X96=1I71=1D32=1X140=1D100=1X135=
可以看到GSAM找到1000个序列中的24个错误,按照cigar可以匹配到图上的相应位置。结果不一定是错误个数最少的结果,一定是最接进最少的结果
-g输入的图gaf格式
-fread文件目前开发了读fa文件,fq以及压缩包
-t线程数
-a输出文件,目前支持json和gaf文件,可以输出多个文件-a out1 -a out2
-p惩罚系数,假入说惩罚系数为p
--tolerant-length=x两个后缀自动机拓展段的最长距离默认为100
-h 查看帮助信息
--include-cigar=true/falsegaf文件是否包括cigar字符串
--beautiful-jsonjson格式是为压缩的还是展开的true为展开,false是压缩的
首先对所有sequence忽略掉图的结构建立广义后缀自动机,下图为广义后缀自动机的一个例子。并且在建立自动机的时候进行预处理。创建状态时令,
firstpos(cur) = len(cur)
id(cur) = getId(cur)
复制状态时需要令
firstpos(clone) = firstpos(q)
id(clone) = id(q)
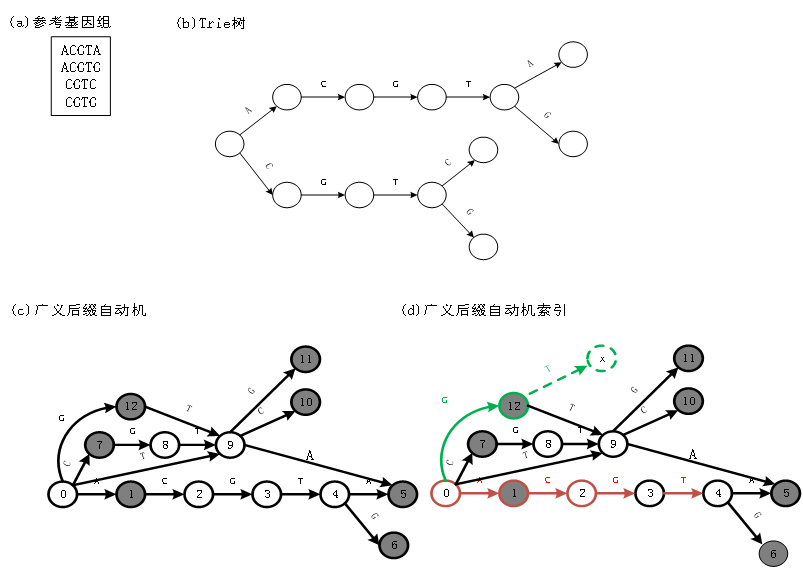
图1
在没有任何错误的情况下read匹配到图上序列的时候,对自动机进行左右方向的拓展。就如图2来说首先“T”匹配到3节点的第一个字符。由于序列图上没有“TA”所以第一段匹配失败了,对“T”这个匹配段向正向和反向拓展,发现没法匹配。所以第一次匹配结束匹配结果是>3[0]。然后从A开始重新匹配“ACGTACGT”这一段,结果为2[0-7]。然后对“ACGTACGT”这段进行正向和反向拓展,正向拓展了4号节点的“ACTT”,然后反向拓展1号节点的“T”。因此第二段匹配了1[7]>2[0-7]>4[0]。
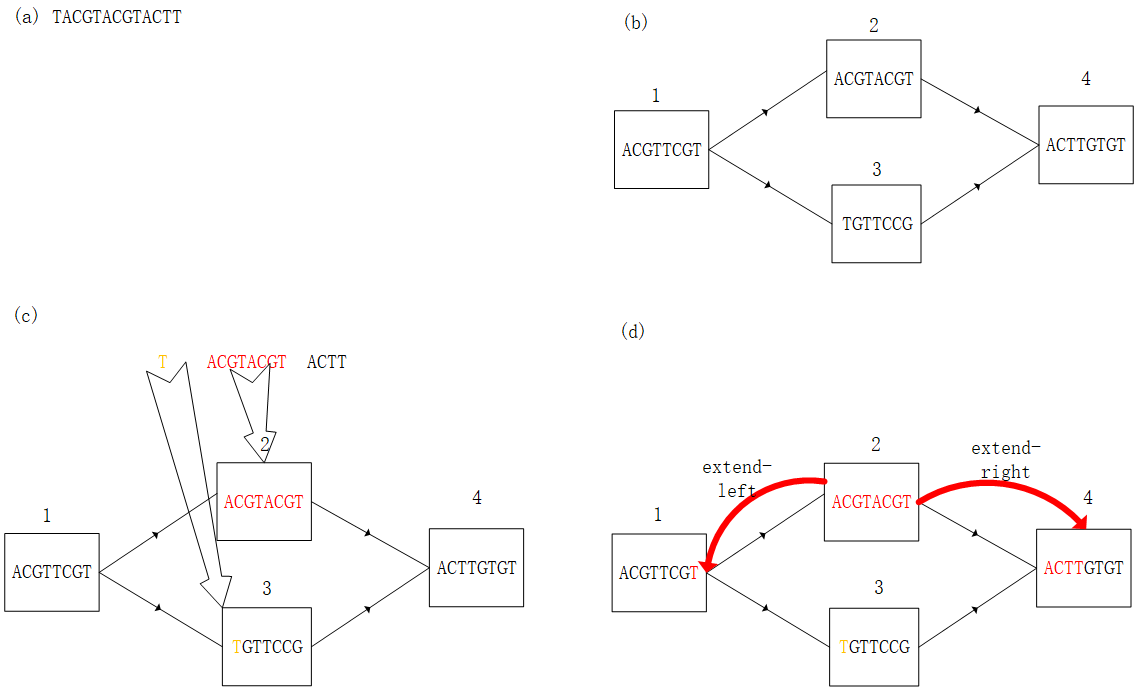
图2
下图(a)、(b)为有一个错误的图上匹配
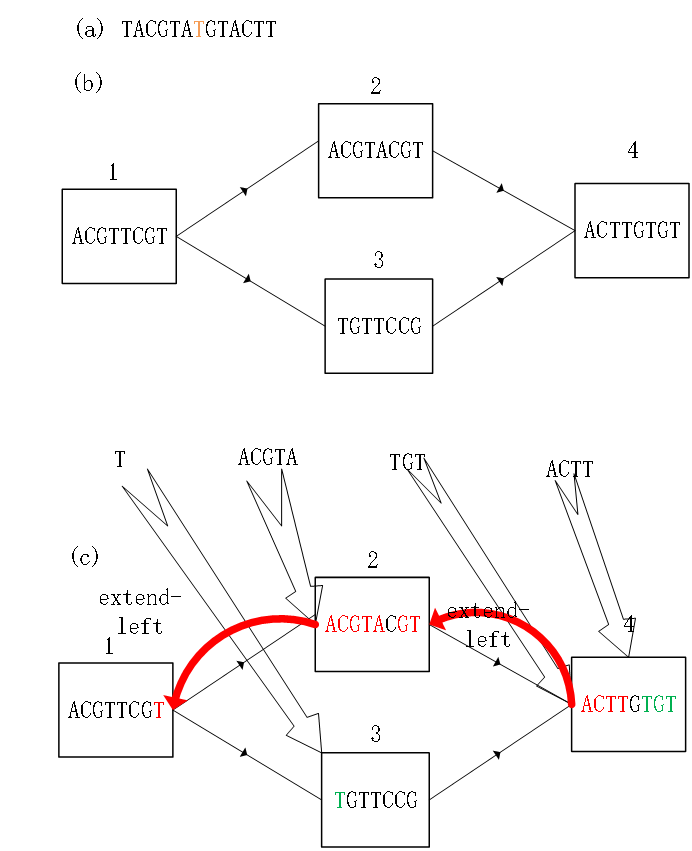
图3
按照上述自动机拓展的方法进行拓展匹配
- “T”匹配到>3[0]
- “ACGTA”匹配到>2[0-4],然后进行拓展,“TACGTA”匹配到>1[7]>2[0-4]
- “TGT”匹配到>4[5-7]
- “ACTT”匹配到>4[0-3],然后进行拓展,“GTACTT”匹配到>2[6-7]>4[0-3]
然后根据这四个匹配串然后推理出路径。这里暴力枚举每个匹配串为起点,然后如果两个匹配串在图上的距离小于d(这是一个参数,默认设置了100,图小的话改小一点)的时候,就将匹配串连起来。如果从某一个起点开始,连起来的路径超过read长度的一半的时候停止。
这么做理论上最坏时间复杂度是 但是,这和匈牙利算法差不多,理论是
 实际上远小于
 ,正常情况下,第一个或者第二个匹配串做为起点就能把路径给找出来了。所以实际运行中,这么干基本上是线性的。
如果直接将read和按照路径拼起来的路径进行dp时间复杂度太高。所以对那些已经匹配的匹配串不管,记成匹配(Match),只对没有的匹配的部分进行dp。按照最短编辑距离(https://www.luogu.com.cn/problem/P2758)进行dp。
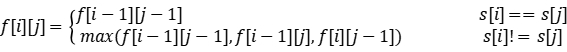
dp的时候记录状态的转移,然后进行回溯。就得到cigar字符串。这个时间复杂度理论上是远小于最坏时间复杂度